3: 인공지능의 편향성과 차별 문제
<디지털 윤리> 시리즈 3: 인공지능의 편향성과 차별 문제
오랜 세월 교직에서 학생들의 올바른 가치관 형성을 위해 고민해 왔고, 이제는 강단에서 많은 분들께 메타버스와 AI 등 새로운 디지털 도구를 강의하며 격세지감을 느낍니다. 우리가 매일 마주하는 인공지능은 무한한 지식을 가진 완벽한 존재처럼 보이지만, 그 이면에는 인간이 가진 치명적인 약점인 '편향성'이 그대로 숨어 있습니다. 인공지능이 인간의 편견을 어떻게 학습하고 차별을 재생산하는지, 그리고 우리는 이를 어떻게 극복해야 할지 살펴보겠습니다.
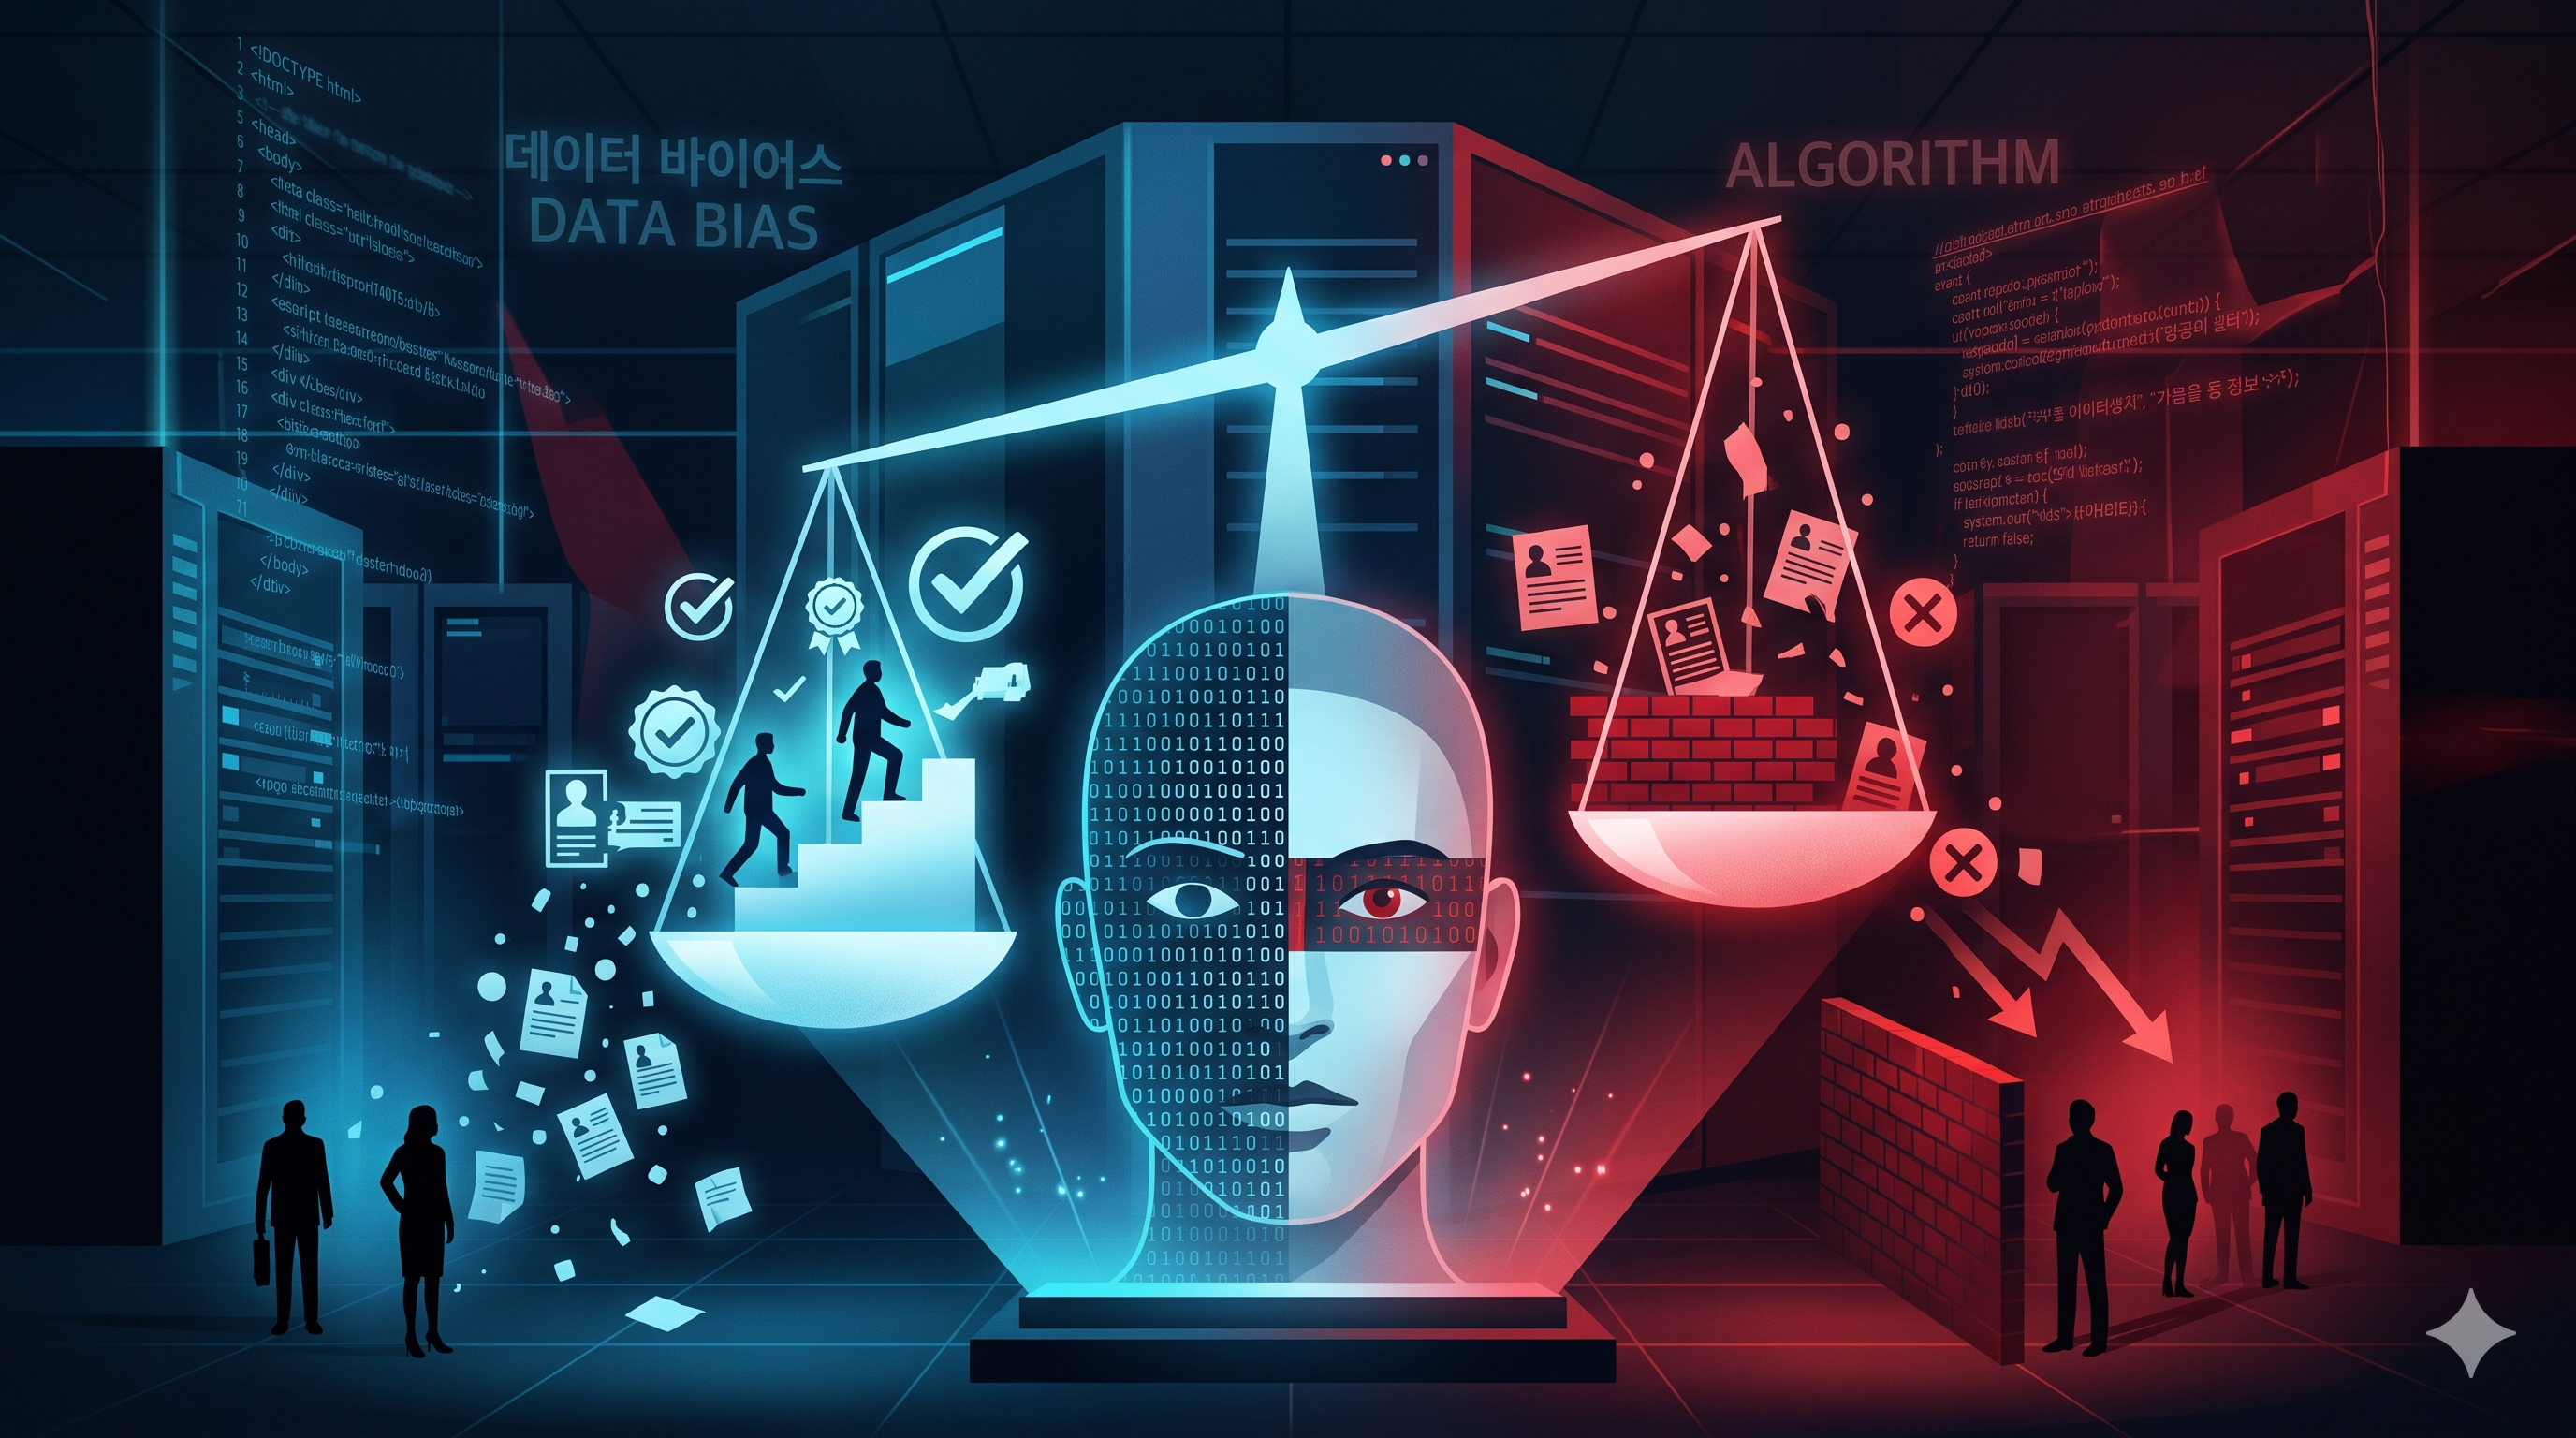
1. 데이터의 거울, 인공지능
인공지능은 스스로 지혜를 깨닫는 것이 아니라, 인간이 만들어낸 방대한 데이터를 학습하며 성장합니다. 문제는 이 '데이터' 자체가 완벽하게 중립적이지 않다는 데 있습니다. 수백 년 동안 인류 사회에 누적된 성별, 인종, 연령, 직업에 대한 고정관념과 편견이 인터넷 상의 글과 이미지에 고스란히 담겨 있고, AI는 이를 무비판적으로 흡수합니다. 마치 백지상태의 아이가 어른들의 거친 언행이나 편견을 그대로 따라 배우는 것과 같습니다. 과거의 불평등한 데이터로 학습한 AI는 결국 미래에도 불평등한 결과를 도출할 수밖에 없는 구조적 모순을 지니고 있습니다.
2. 일상 속 AI 편향성의 실제 사례
이러한 편향성은 단순한 이론적 우려를 넘어 이미 우리 삶 곳곳에서 실질적인 차별로 나타나고 있습니다. 기업의 AI 채용 시스템이 과거의 합격자 데이터를 바탕으로 남성 지원자에게 더 높은 점수를 주거나 여성의 이력서를 배제하는 사례가 대표적입니다. 또한, 얼굴 인식 기술이 유색 인종이나 여성의 얼굴을 제대로 인식하지 못해 범죄자로 오인하거나, 금융권의 AI 대출 심사 시스템이 특정 지역이나 인종에게 불리한 조건을 제시하는 일도 벌어졌습니다. 이는 기술의 편리함 뒤에 숨어 누군가의 기회를 박탈하고 사회적 불평등을 고착화하는 심각한 윤리적 문제입니다.
3. 공정한 AI를 위한 우리의 역할과 디지털 리터러시
AI의 편향성을 바로잡기 위해서는 개발자와 사용자 모두의 노력이 필요합니다. 기술을 설계하는 사람들은 학습 데이터의 다양성을 확보하고 편향성을 검증하는 알고리즘을 구축해야 합니다. 하지만 더 중요한 것은 기술을 활용하는 우리들의 자세입니다. AI의 결과물을 절대적인 진리로 맹신하지 않고, 비판적 사고를 통해 그 안에 숨은 차별적 요소를 짚어내는 '디지털 리터러시'를 갖추어야 합니다. 올바른 질문을 던지고 결과의 공정성을 의심할 줄 아는 깨어 있는 시민 의식이 바탕이 될 때, 비로소 AI는 차별의 도구가 아닌 상생의 도구로 자리 잡을 수 있을 것입니다.
결국 기술의 방향을 결정하는 것은 우리 인간의 윤리적 잣대입니다. 차별 없는 따뜻한 디지털 사회를 후대에게 물려주기 위해, 기술을 바라보는 우리의 눈높이도 한층 더 성숙해져야 할 때입니다.
관련글 더보기: 메타버스 뒤에 숨은 익명성,